Meta schließt erste Ausbaustufe des KI-Rechenverbunds Prometheus ab
Meta hat die erste Ausbaustufe seines KI-Rechenverbunds Prometheus abgeschlossen und damit bereits neue Modelle trainiert. Der Anbieter baut den Standort weiter aus und verbindet dafür mehrere Gebäude zu einem gemeinsam arbeitenden Rechensystem.
Am 19. Oktober 2026 veröffentlichte Meta technische Einzelheiten zum Projekt in New Albany, Ohio. Der auf Gigawatt-Größenordnung ausgelegte Verbund umfasst derzeit Hunderttausende Grafikprozessoren, kurz GPUs. Sie sind über mehrere Gebäude hinweg so eng verbunden, dass sie wie ein einziger Rechner arbeiten. Im Vollausbau sollen rund eine Million dieser Rechenbeschleuniger zusammenarbeiten. Vor zwei Jahren betrieb der Standort noch ein herkömmliches Rechenzentrum für Internetdienste. Die bisherige Infrastruktur diente bereits dem Training der KI-Modellfamilie Muse, einschließlich Muse Wonder, Metas neuer KI-Spitzenmodelle für die selbstständige Bearbeitung persönlicher und beruflicher Aufgaben.
Flüssigkeitskühlung für dicht gepackte Rechenleistung
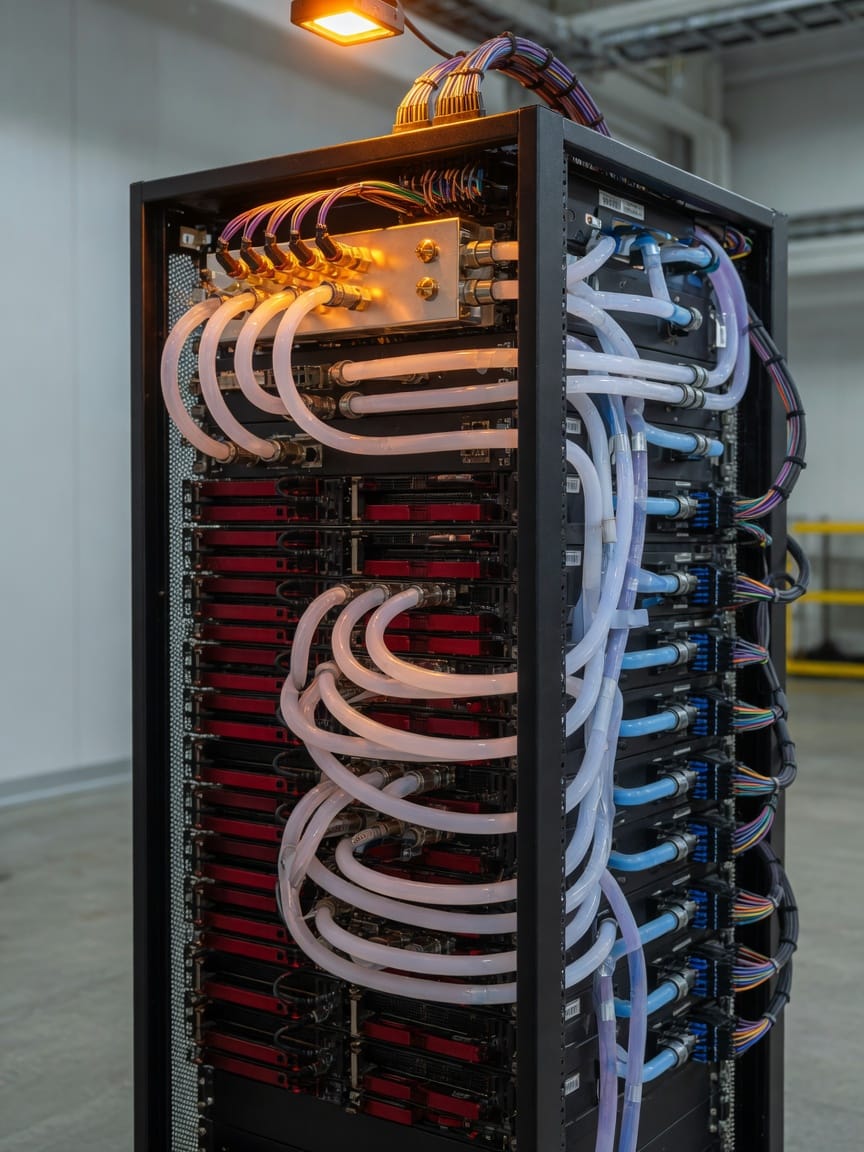
Prometheus verwendet derzeit zwei Hardwareplattformen von NVIDIA. Die neuere Variante Clemente, Metas zweite Plattform für KI-Rechenbeschleuniger, bündelt mit dem System GB300 NVL72 insgesamt 72 GPUs in einem Serverschrank, die wie ein einziger Beschleuniger arbeiten. Den Aufbau zeigt Meta in einer Animation des GB300-NVL72-Systems. Dessen Leistungsaufnahme beziffert Meta auf rund 135 Kilowatt. Der Anbieter nennt eine Leistungssteigerung von fünf bis zehn Prozent gegenüber GB200 NVL72, der ersten, ebenfalls eingesetzten NVIDIA-Plattform. Clemente unterstützt sowohl eine luftunterstützte Flüssigkeitskühlung als auch die Flüssigkeitskühlung des Gebäudes. Prometheus nutzt zudem geschlossene Flüssigkeitskreisläufe.
Weniger Unterbrechungen beim Modelltraining
Meta erreichte nach eigenen Angaben beim grundlegenden Training von Muse Wonder einen produktiv nutzbaren Rechenzeitanteil von mehr als 85 Prozent. Gemeint ist der Anteil der Rechenzeit, der tatsächlich dem Training dient und nicht durch Ausfälle verloren geht. Beim bestärkenden Lernen lag dieser Anteil über 90 Prozent. Dabei handelt es sich um einen weiteren Trainingsschritt der Modelle. Einzelne Fehler können laut Meta einen gesamten Trainingslauf anhalten. NVIDIA und Meta untersuchen deshalb gemeinsam Störungen und deren Ursachen.
Für den gebäudeübergreifenden Datenaustausch nutzt Prometheus ein eigenes Netzwerk mit Verbindungen über zwei bis mehr als 100 Kilometer. Innerhalb eines Gebäudes verbindet ein gebäudeinternes Netzwerk bis zu 20.736 GPUs. Als nächste Hardwareplattform kündigte Meta ein System auf Basis von NVIDIA Vera Rubin NVL72 an, einer kommenden Generation von KI-Rechenbeschleunigern.
Dieser Artikel wurde KI-generiert erstellt. Die Themenauswahl trifft die Redaktion, die redaktionelle Verantwortung liegt bei KI-Prüfstand.